 bingdada
Skild AI 让机器人在虚拟球场中通过自我对弈训练,仅设定进球目标,机器人便自行演化出盘带、护球、抢断等足球技能。其底层依托 Skild Brain 基础模型实现跨硬件控制,但仿真到真实世界的迁移仍是核心挑战。
设想一支足球队,没有教练布置战术,没有训练课拆解动作,球员唯一要做的就是赢下比赛。听起来像是天方夜谭,但美国具身智能公司 Skild AI 最近展示的成果,恰恰把这个设想变成了工程现实。
在一段公开演示中,一台身着阿根廷国家队配色球衣的人形机器人完成了连贯的带球推进、变向摆脱和射门动作。更值得玩味的是,研发团队从未针对「盘带」「护球」「抢断」这些子技能编写过任何奖励规则——训练系统里只写了一条目标:把球送进门里。
这意味着,那些看起来颇具职业风范的足球动作,是机器人自己在反复试错中「发明」出来的。
这套训练逻辑并不陌生。2016 年,AlphaGo 击败李世石的消息震动了整个科技界,其核心武器之一就是自我对弈——让 AI 与自己的历史版本反复过招,在胜负信号中自行发现人类棋手未曾涉猎的定式。
Skild AI 做的事情,本质上是把这条路线从离散的棋盘搬到了连续的物理空间。团队在 NVIDIA Isaac Sim 构建的仿真环境中搭建了一座虚拟球场,让机器人面对的唯一对手就是自己此前的模型快照。新版本若能战胜旧版本,就会成为下一轮训练中更强大的陪练。每一轮进步,都在自动制造下一道更难的题目。
据 Skild AI 技术博客披露,机器人最初进入虚拟球场时连稳定行走都困难;随着训练推进,它逐渐掌握了跌倒后自主起身的能力,随后又演化出绕开防守、用身体卡位护球、主动上抢等复杂行为。这些动作没有任何一条被工程师显式规定,它们被保留下来的唯一理由是:能提高赢球概率。
要理解 Messinator 为何能如此灵活,需要把视线拉回到 Skild AI 更早的技术布局。
2025 年 7 月,该公司发布了一款名为 Skild Brain 的机器人基础模型,核心理念可以概括为一句话:任意机器人、任意任务、同一颗大脑。这直接挑战了行业长期存在的「一种硬件配一套控制程序」的惯例。
紧接着,团队又公开了一组 omni-bodied 训练成果。在仿真环境中,他们生成了约 10 万种结构各异的机器人身体,让同一个模型累计经历约 1000 个仿真年的训练。测试阶段,模型需要直接接管训练中从未见过的硬件形态——即便机器人突然断腿、关节锁死或轮子卡住,模型也能在线调整重心和运动策略,部分场景下几秒内就能重新找到平衡并摸索出新的移动方式。
这套方法的精妙之处在于:当模型见过的身体足够多样,死记硬背就彻底失效了。它被迫去理解平衡、关节力矩、重心分布和动力传递之间更底层的物理规律,而不是记住某一款机器人的固定步态。Messinator 正是这条技术路线的延伸——Skild Brain 提供控制身体、维持平衡和应对碰撞的基础能力,自我对弈则负责回答「下一步怎么做才能赢」这个策略问题。
Skild AI 成立于 2023 年,脱胎于卡内基梅隆大学的机器人研究体系。团队汇聚了来自 CMU、斯坦福、UC Berkeley 等高校的研究者,以及曾在 Meta、Tesla、NVIDIA、Google 等机构任职的工程师。
联合创始人兼 CEO Deepak Pathak 的学术轨迹几乎串起了公司的整条技术路线。他在 UC Berkeley 获得计算机博士,师从计算机视觉领域的知名学者 Alyosha Efros 和 Trevor Darrell,此后在 Meta AI Research 从事研究,并与机器人学习专家 Pieter Abbeel 在伯克利有过合作。加入 CMU 后,他成为机器人研究所和机器学习系教授。
Pathak 最具代表性的研究方向之一是「好奇心驱动的探索」——与其让机器依赖人类设计的外部奖励,不如赋予它内在动力,让它对陌生现象产生探索欲,并在自主探索中习得新能力。这一思路后来延伸到自监督机器人学习、视觉模仿学习、Sim2Real 和自适应控制等方向。
另一位联合创始人兼总裁 Abhinav Gupta 同样来自 CMU 机器人研究所,博士毕业于马里兰大学。他曾参与建立 Meta AI Research 匹兹堡实验室并担任研究管理职务,长期深耕大规模视觉学习、自监督学习和物理常识推理,是早期倡导「让机器人通过自主交互收集训练数据」的研究者之一。
自我对弈在虚拟环境中跑通 140 年,并不等于机器人就能直接站上真实球场。仿真与现实的物理差异——摩擦力、传感器噪声、电机响应延迟——始终是具身智能落地的核心瓶颈。Skild AI 目前展示的真人对抗场景,仍然是在受控条件下进行的初步验证。
值得注意的是,国内团队在这一方向上并非旁观者。宇树科技的人形机器人已经在运动控制和动态平衡方面展现出相当高的完成度;智元机器人、星海图等公司也在探索基于强化学习的全身运动策略。在「用仿真训练替代人工示教」这条思路上,国内高校如清华大学、上海交通大学的研究团队同样发表了大量关于 Sim2Real 迁移和自监督技能发现的工作。差异在于,Skild AI 更强调单一基础模型对多种硬件形态的通用控制能力,而国内团队目前更多聚焦于特定本体上的运动技能优化。两条路线各有侧重,但都指向同一个判断:机器人学会新技能的方式,正在从「人类手把手教」转向「自己练、自己输、自己总结」。
在仿真环境中,Skild AI 的机器人在只设定「进球得分」这一终极目标的前提下,通过自我对弈自行演化出了盘带、护球、抢断等复杂动作。这些技能并非工程师逐条编写,而是模型在反复比赛中发现的有效策略。但在真实物理世界中,受限于传感器精度和执行器响应,目前仍处于初步验证阶段。
自我对弈是一种让 AI 与自己的历史版本反复对抗的训练方法。每一轮中,表现更好的策略被保留下来,成为下一轮更难对付的对手。这种方法最早在 AlphaGo 等棋类 AI 中取得突破,如今被扩展到机器人控制领域,让机器人在没有人类示范的情况下自主发现新技能。
传统机器人控制通常针对特定硬件编写专门程序,换一种身体就需要重新开发。Skild Brain 的目标是用同一个模型控制不同形态的机器人,通过在约 10 万种仿真身体上训练,迫使模型学习通用的物理规律而非固定步态。这意味着机器人在面对从未见过的硬件故障时,也能在线调整策略。
有。宇树科技、智元机器人等公司在人形机器人的运动控制方面已有公开成果,清华大学、上海交通大学等高校也在 Sim2Real 迁移和自监督技能发现方向发表了多项研究。国内路线目前更侧重于特定本体上的运动技能优化,而 Skild AI 更强调跨硬件形态的通用控制。
Bingdada 是一个专注 SEO、GEO(生成式引擎优化)与 AEO(答案引擎优化)的内容平台,由资深内容编辑、SEO 技术工程师与 AI 研究专家组成的团队持续运营。我们追踪搜索引擎与生成式 AI 的最新动态,为读者提供准确、实用、可落地的方法论与行业洞察。
编辑团队:内容策划 · 技术编辑 · AI 研究组
网站:bingdada.com
© 2026 Bingdada. 保留所有权利。
Поместите бренд в ленту читателя
Рекламные места внутри статей — моменты высокого внимания, идеальны для запуска продуктов и набора на мероприятия.
SEO & GEO 技术探索者,专注于搜索引擎优化和生成式引擎优化。
资本狂热与真实作业之间的鸿沟揭示了物理智能的规模化困局。华为联合多家机构发布的报告指出,云边端协同是破解实时性与复杂性两难的系统路径,三域协同与一网贯通构成核心架构。
当VLA模型在物理扰动下频频失效,世界模型成为具身智能跨越商业化门槛的新路径。美梦空间联合索辰科技发布Physical-WAM与RoboTwin-Phys,从物理Token表征到物理漂移评测,为机器人补上"物理课"。
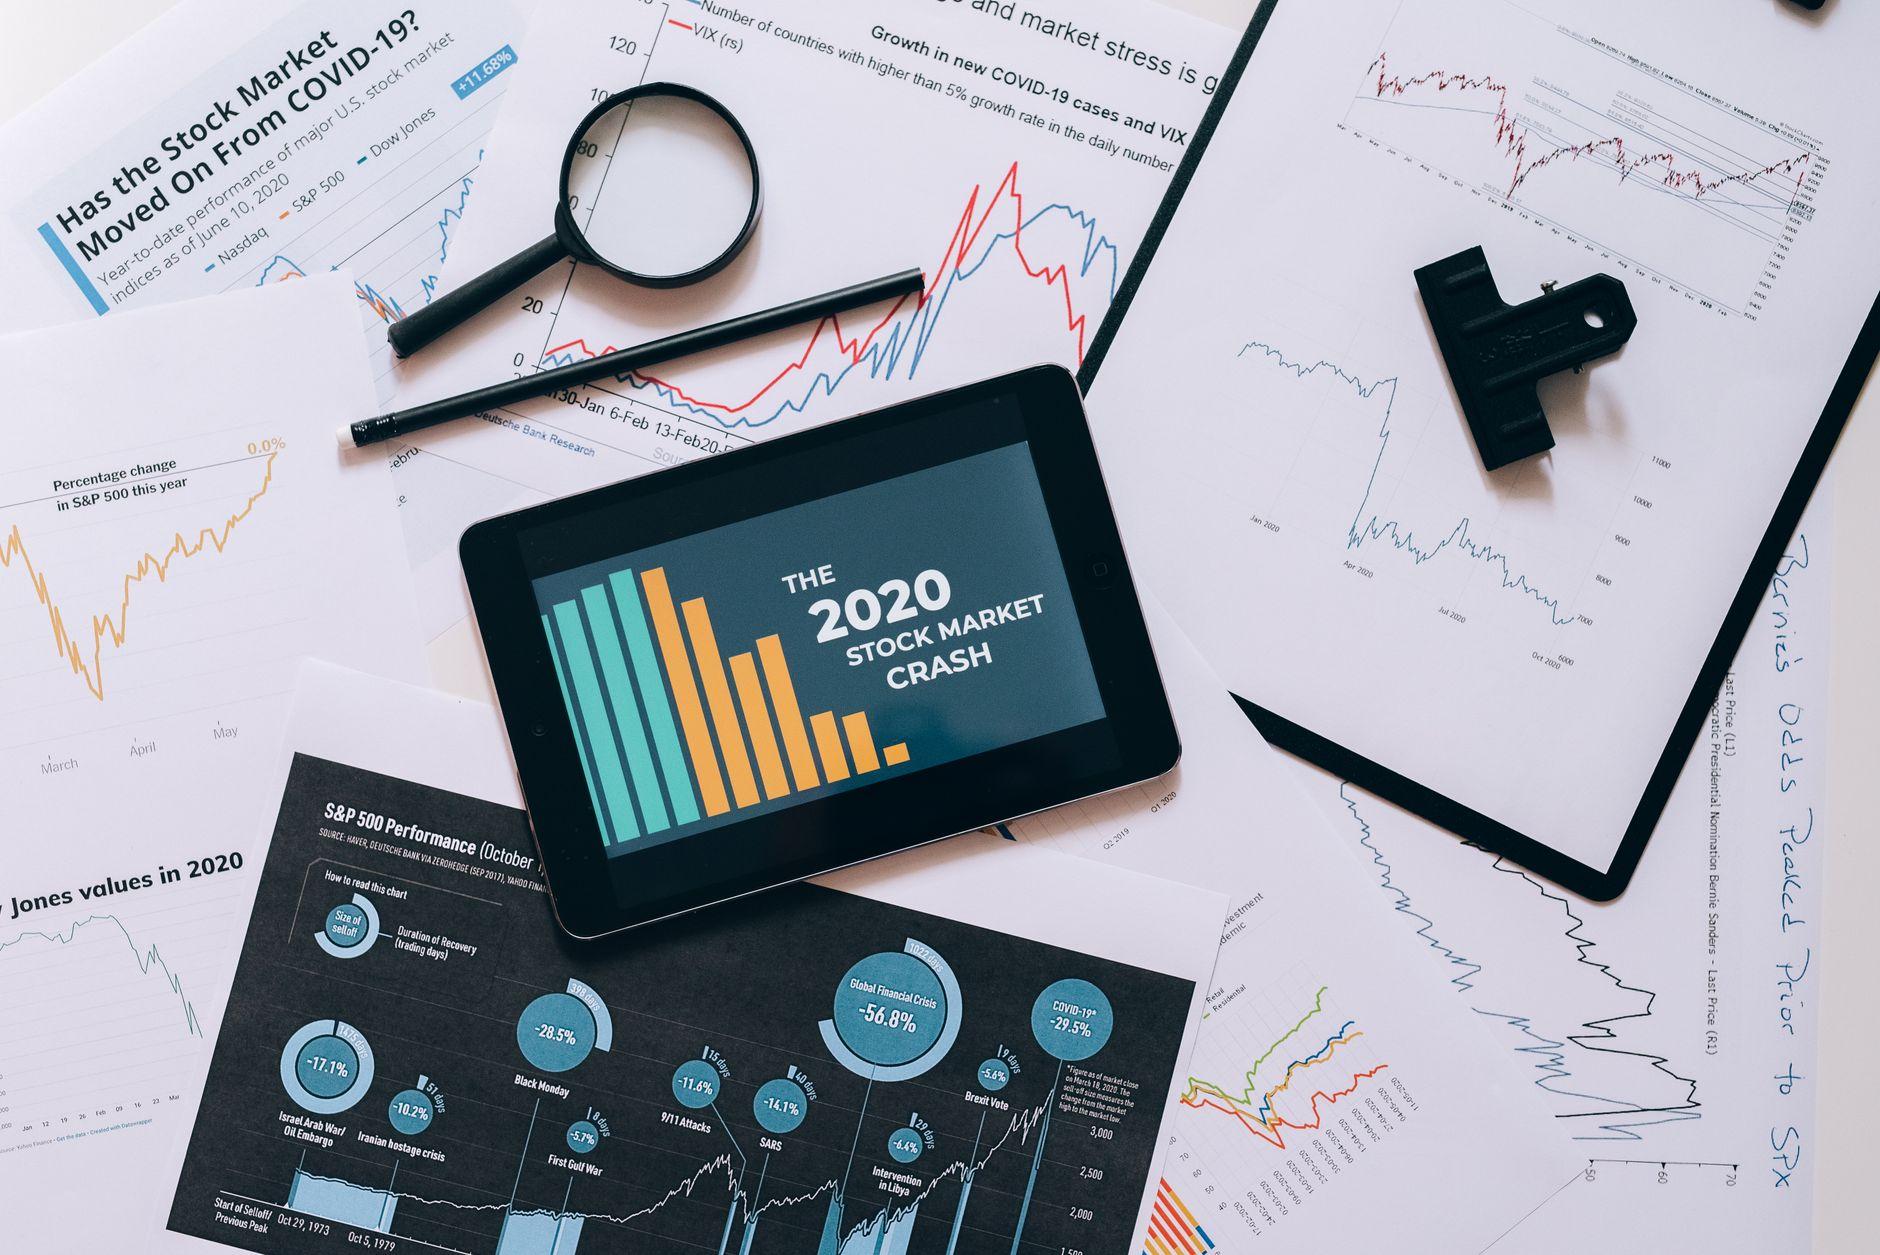
一批以具身智能为标签的机器人公司集中登陆港交所,却在上市后普遍跌破发行价。标签与业务之间的断层正在透支行业的资本市场信用,后来者将面对更严苛的定价环境。
Получайте свежие материалы по SEO и GEO.
Мы уважаем вашу конфиденциальность. Отписаться можно в любой момент.
Войдите, чтобы присоединиться к обсуждению
