 bingdada
AMD 的个人 AI 战略旨在通过大内存 PC 和工作站,将 AI 计算从云端转移到本地设备,以降低成本、增强隐私并提升响应速度。该战略依赖开放权重模型的小型化,中国模型如千问、GLM 成为关键案例,并有望重塑 AI 算力分布格局。
在 2026 年的 IFA 展会上,AMD 的开幕演讲没有聚焦于传统的新显卡或跑分数据,而是将全部重心放在了一个概念上:Personal AI(个人 AI)。这标志着芯片巨头正试图重新定义 AI 计算的范式——将重心从云端数据中心拉回到用户手中的设备上。
过去几年,生成式 AI 的进化路径清晰可见:从基础的对话能力,到多模态理解,再到复杂的推理和 Agent 式任务执行。但随之而来的是工作负载的指数级增长。AMD 计算与图形部门负责人 Jack Huynh 在演讲中透露,一次普通的 ChatGPT 对话仅需数百 token,而一个规划全家旅行的 Agent 任务动辄消耗数十万 token。
这种变化在宏观数据上体现得更为惊人:全球月度 AI token 处理量已从一年前的约 700 万亿跃升至 1700 万亿,预计到 2030 年将达到每月 12 亿亿。与此同时,93% 的企业承认在 AI 预算上超支。一个活跃用户每天消耗 1500 万输出 token,在云端运行的成本高达 300 欧元,一年下来接近 10 万欧元。
正如 Jack 所说:“我们不能只是花更多钱,必须算得更聪明。” 这正是 AMD 押注个人 AI 的核心逻辑:通过将计算任务分流到本地设备,既能降低成本,又能解决隐私和延迟问题。
本地化 AI 的前提是,开放权重模型在性能上足以媲美闭源前沿模型。过去一年,这一差距正在急剧缩小。去年 OpenAI 发布的 GPT-OSS-120B 在 GPQA 研究生级推理基准上拿下 80 分,而几个月后,阿里的 Qwen3.5-9B 仅用 90 亿参数就超越了这一分数——参数减少 13 倍,性能反而更强。
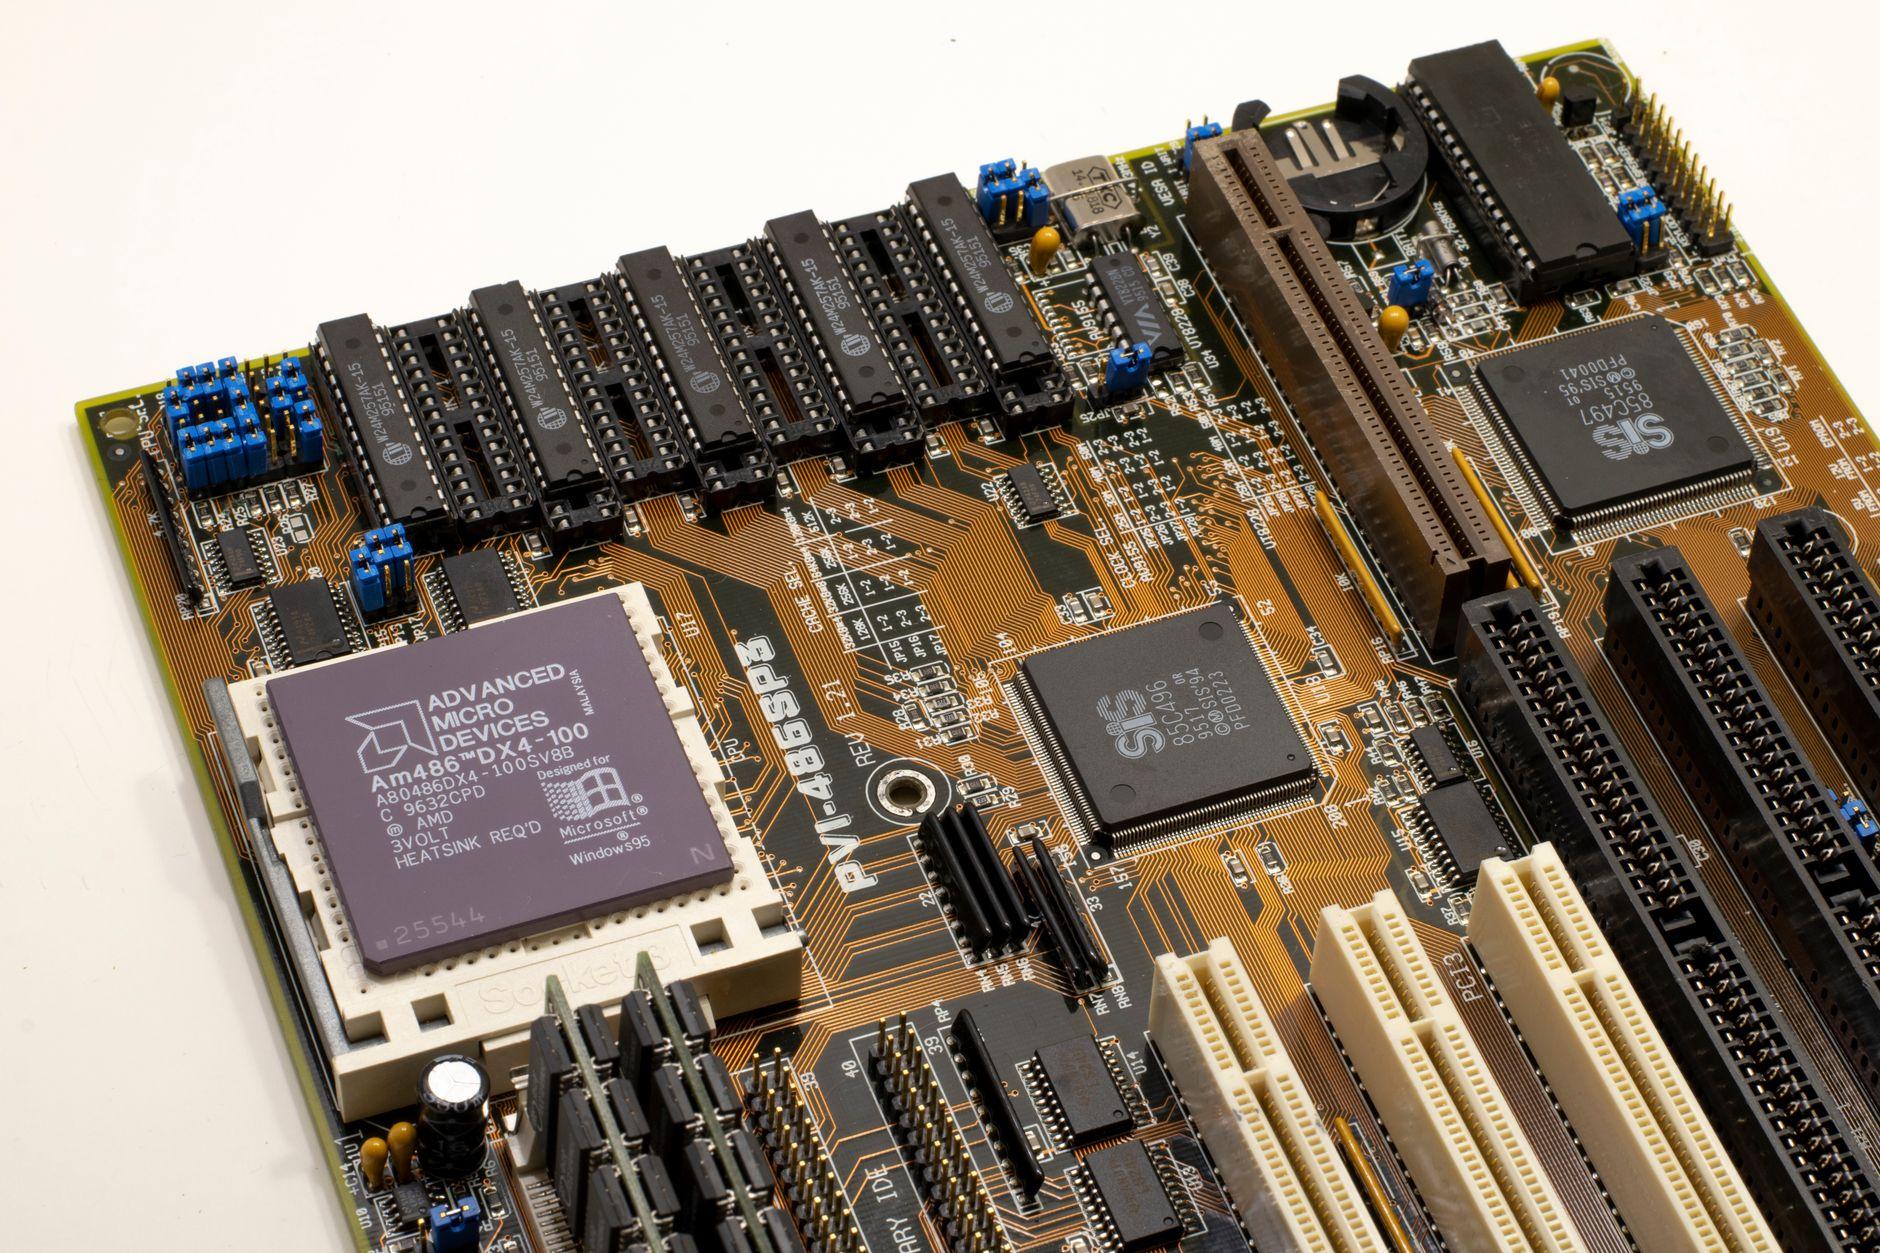
AMD 的硬件路线图也沿着这条曲线展开:新一代 Gorgon Halo 平台(市场名 Ryzen AI Max 400 系列)将统一内存从 128GB 提升至 192GB,使得本地可运行的模型参数上限从 2000 亿跃升至 3000 亿。现场演示中,智谱的 GLM-5.3-Flash(3200 亿参数)得以在 Gorgon Halo 上流畅运行,并在特定基准上超越了云端 Claude Fable 5 的表现,而后者处理 1000 万输出 token 的成本高达 500 欧元。
这种“大内存 + 强算力”的组合,让 PC 从单纯的消费终端变成了可以承载复杂 AI 任务的本地节点。AMD 还展示了搭载 Gorgon Halo 的联想 ThinkCentre X Ultra——一台可以放在桌面上的迷你主机,最多支持四台组集群,以及首次曝光的下一代 HP ZBook(代号 Sundance),它能够凭一句 prompt 实时生成 3D 世界并流畅运行《微软飞行模拟》。
AMD 的“个人 AI”愿景并未止步于 PC。在演讲尾声,Jack 揭晓了 Threadripper Halo Station——一台配备 96 核 Threadripper PRO 与数据中心级 Instinct MI350P 的桌边工作站。现场展示机搭载两张 MI350P,预留四卡扩展空间,系统内存最高 2TB,HBM3E 总容量达 576GB,整机液冷。AMD 声称它能运行超过 1 万亿参数的模型,并冠以“全球最强工作站”之名。
这台机器的意义在于,它将个人 AI 的边界从单一设备扩展到了办公室的共享节点。开发者可独享,团队亦可协作调用,那些个人电脑无法承载的任务,也无需立刻跳回按 token 计费的公有云。这实际上构建了一个从终端到边缘的 AI 算力连续体。
然而,硬件能装下模型,并不等于 Agent 能在电脑上安全、高效地工作。它需要跨应用、服务与文件执行操作,操作系统必须足够友好——如果算力很强,但只能运行 Ubuntu,普通用户根本无从下手。AMD 与微软、SUSE 的合作,正是为了补齐 Windows 开发与企业部署的短板。此外,软件层面必须严格控制 Agent 的权限边界,明确它能访问什么、修改什么,这涉及隐私与安全的关键议题。
AMD 将本地计算、隐私控制与个人上下文视为个人 AI 的三大支柱。所谓“个人上下文”,是 Jack 眼中超越应用、模型与算力的第四层——同一句“帮我准备明天”,对上班族意味着客户会议,对学生则意味着考试复习。模型不仅要懂世界知识,还要理解提问者的具体情境。
值得注意的是,AMD 演讲中频繁出现的 DeepSeek、千问、GLM 等模型,正是中国 AI 开源生态的代表。从 Qwen3.5-9B 以更小参数超越 GPT-OSS-120B,到 GLM-5.3-Flash 在本地与云端模型的比拼,中国团队在开放权重模型上的进展已成为全球硬件厂商展示本地 AI 能力的最佳注脚。
在国内市场,这些模型与华为昇腾、寒武纪等国产加速硬件的适配也在加速。例如,DeepSeek 系列模型已广泛部署于国产算力集群,而通义千问与智谱清言则为开发者提供了从云端到本地的无缝迁移路径。这种“模型+硬件”的本土化协同,正在重塑中国 AI 计算的生态版图。
AMD 的这场演讲,或许预示着 AI 算力分布的一个重要转折。当模型足够小、硬件足够强,AI 计算的重心便可能从云端部分回迁至本地。这不仅关乎成本与效率,更关乎数据主权与用户体验。正如 Jack 在演讲中引用的一句诗意总结:“白天创造世界,晚上打游戏。一手是真实世界,一手是我想象的世界。” 个人 AI 的终极形态,或许就是让每个用户都能在自己的设备上,以最低成本、最高隐私地驾驭 AI 的无限潜力。
对于 PC 厂商而言,这无疑是一场及时雨。在传统硬件需求疲软之际,AI 模型的本地化浪潮带来了新的换机驱动力。而对于开发者与企业,这意味着更灵活、更可控的 AI 部署选项。但挑战同样存在:如何平衡本地算力与云端的协同?如何确保安全框架跟上 Agent 的自主能力?这些问题的答案,将决定个人 AI 是愿景还是现实。
AMD 的个人 AI 战略是指将 AI 计算从云端数据中心转移到用户本地设备(如 PC 和工作站),通过本地处理敏感数据和个人上下文,降低成本并增强隐私保护。它强调本地计算、隐私控制和个人上下文三大支柱。
主要原因是成本与隐私。云端推理成本高昂,例如一个活跃用户每天消耗 1500 万输出 token,年成本近 10 万欧元。此外,敏感数据留在本地更安全,且本地推理延迟更低,体验更流畅。
Gorgon Halo(Ryzen AI Max 400)是 AMD 的新一代 PC 平台,统一内存从 128GB 提升至 192GB,可本地运行高达 3000 亿参数的模型,支持开放权重模型如 GLM-5.3-Flash 的流畅推理。
它面向专业开发者和团队,作为办公室共享节点,可运行超过 1 万亿参数的模型,填补了个人 PC 与公有云之间的算力空白。
Bingdada 是一个专注 SEO、GEO(生成式引擎优化)与 AEO(答案引擎优化)的内容平台,由资深内容编辑、SEO 技术工程师与 AI 研究专家组成的团队持续运营。我们追踪搜索引擎与生成式 AI 的最新动态,为读者提供准确、实用、可落地的方法论与行业洞察。
编辑团队:内容策划 · 技术编辑 · AI 研究组
网站:bingdada.com
© 2026 Bingdada. 保留所有权利。
Поместите бренд в ленту читателя
Рекламные места внутри статей — моменты высокого внимания, идеальны для запуска продуктов и набора на мероприятия.
SEO & GEO 技术探索者,专注于搜索引擎优化和生成式引擎优化。
智谱完成约50亿美元融资,六成资金投向下一代GLM与完全自训练体系,探索递归式自我改进循环。本文拆解其资金结构、技术路线与国产大模型资本竞赛的深层逻辑。
匿名AI模型Ox Alpha在OpenRouter上线,引发关于其开发者的猜测。本文分析其技术特点、可能的来源及行业影响,并对比国内AI进展。
中美建立AI对话机制与三大运营商叫停0元购机,看似无关的两件事共同指向技术治理逻辑的转变。本文从算力投资回报、智能体失控、数据隐私执法等维度,解析全球科技产业正在经历的制度重构。
Получайте свежие материалы по SEO и GEO.
Мы уважаем вашу конфиденциальность. Отписаться можно в любой момент.
Войдите, чтобы присоединиться к обсуждению
