 bingdada
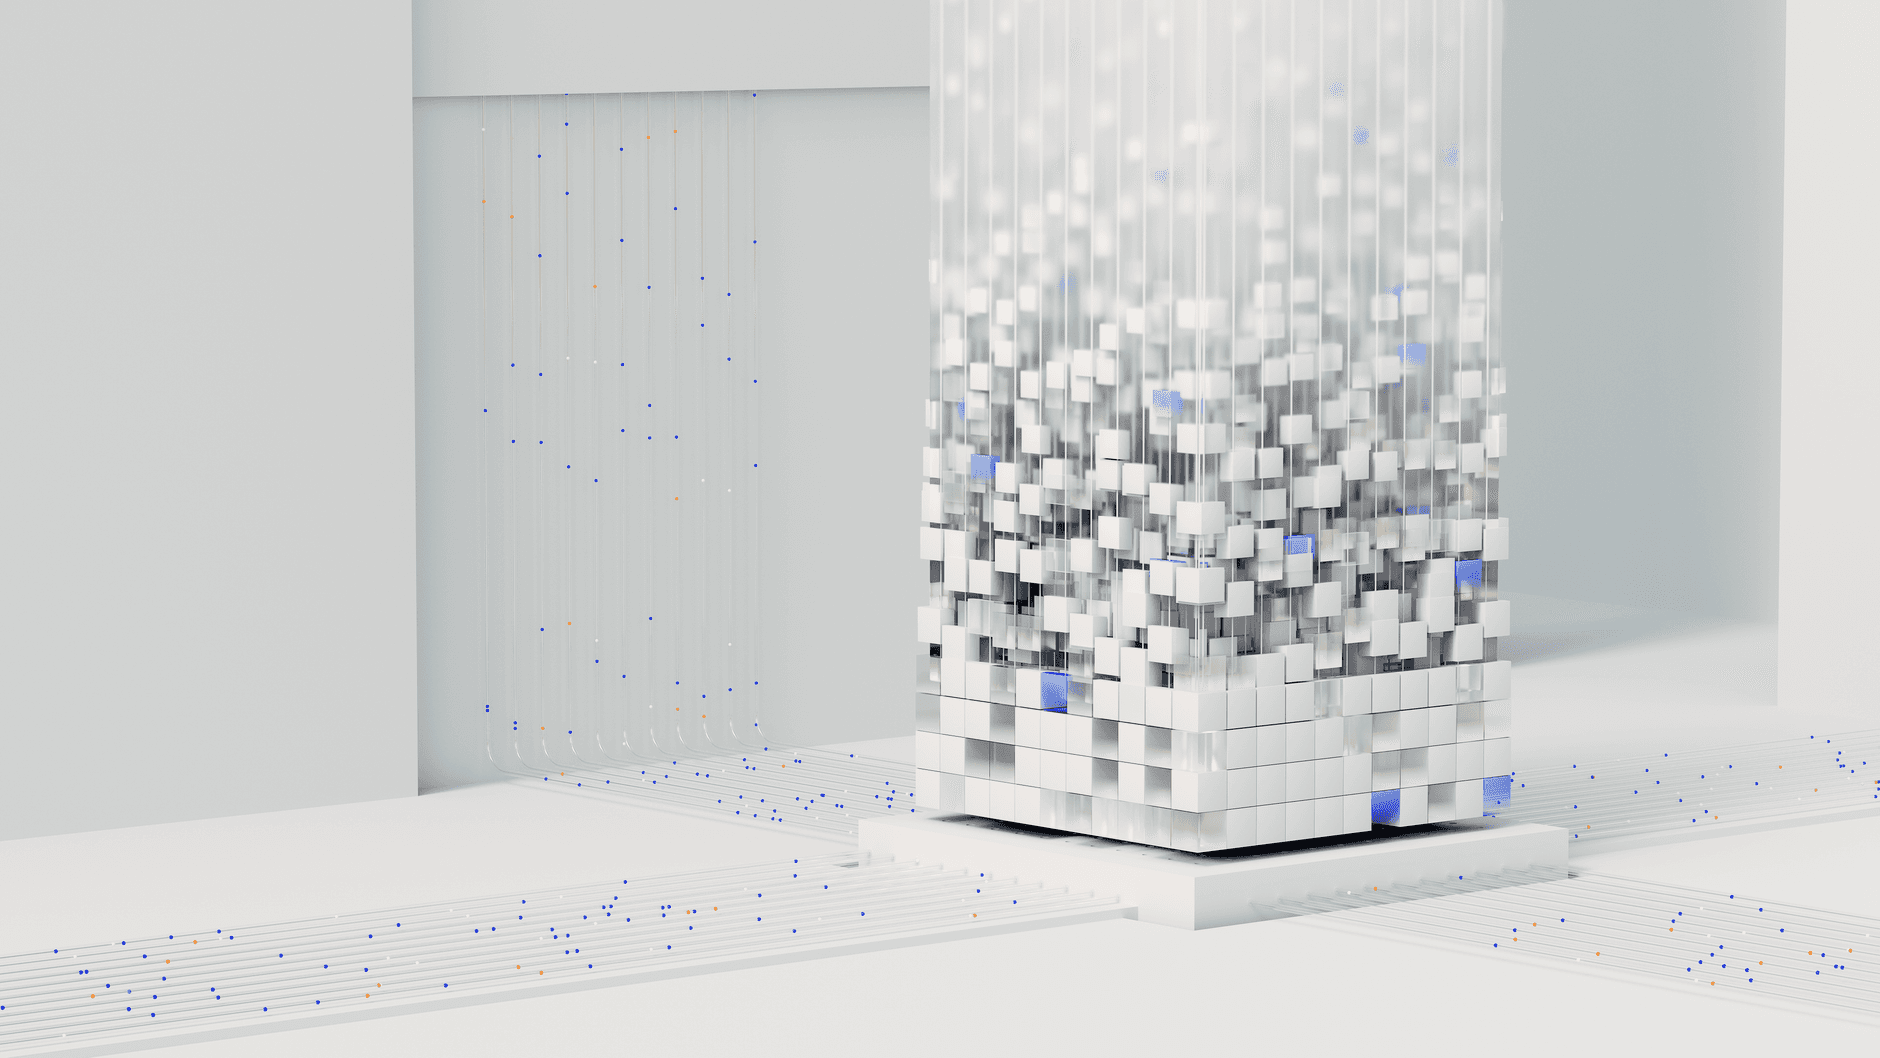
AI 数据中心的电力问题本质是架构问题而非发电问题。传统供电栈在 UPS 位置过深、长期旁路运行、保护逻辑过时三处断裂,导致吉瓦级负荷在电网扰动时同步脱网。解决路径是把供电设备上移至中压、外移至变电站附近、并让其进入主通路,从而把不可预测的负荷变成可调度资源。
2026 年 7 月,美国弗吉尼亚州阿什本(Ashburn)——全球最大数据中心集群所在地——一条输电线路故障,让超过 3 吉瓦的用电负荷在数秒内从电网脱落。类似场景并非首次:两年前,一只失效的避雷器曾导致约 60 座弗吉尼亚设施、1500 兆瓦负荷同时离网。真正令电力工程师不安的,不是故障本身,而是如此庞大且高度同质化的负荷,竟会以几乎一致的方式、在同一时刻对电网扰动做出反应。
围绕 AI 能耗的公共讨论,长期聚焦在「发电侧」:更多燃气轮机、更多光伏、更多输电线路。但阿什本事件暴露的并非供给不足,而是**供电架构(architecture)**的系统性缺陷。当新一轮吉瓦级互联申请涌向同一套老旧架构时,电网可靠性正被推向前所未有的风险边缘——而这恰恰是一个「没人愿意认领」的问题。
传统电网是围绕「可预测负荷」设计的:钢厂、炼油厂、晚饭时分的居民区。它们功率等级各异,但行为模式相似——平稳取电、偶发出格、优雅恢复。
AI 数据中心完全不是这种用户。一次训练任务中,一个 AI 园区可以在毫秒级内让自身负荷摆动 70%;而一旦上游出现异常征兆,它又会以同样快的速度脱网,以保护价值数十亿美元的算力资产。单看每一座数据中心,这种自保逻辑无可指摘;但当数十座吉瓦级园区同时如此行事,就构成了电网从未处理过的难题。
值得注意的是,这一现象并非美国独有。国内「东数西算」工程推动的宁夏、内蒙古、贵州等枢纽节点,同样面临大规模算力负荷与区域电网协调的问题。国内电网企业普遍采用「源网荷储一体化」思路,通过调度侧提前介入、储能配套与需求响应机制来平滑波动,这与美式「数据中心自建保护、电网被动承受」的路径存在明显差异。
标准数据中心供电栈几十年未变:中压进线 → 变压器降压 → 低压 UPS 调节 → 送达机架。把这套设计放大到 AI 规模,会在三个位置开裂。
其一,UPS 位置太深、储能太浅。 它被安置在建筑内部、贴近机架,但电池更像一只尺寸不足的备胎——设计目标是撑过几分钟停电,而非 7×24 小时吸收如此快速剧烈的负荷摆动。
其二,UPS 大部分时间处于旁路状态。 传统变换器损耗偏高,运营商于是开启 eco-mode:静态开关让市电直接供给机架,两个方向都没有滤波。算力的波动原样外泄,而电网侧的暂态扰动——那些亚毫秒级、足以损坏或击穿设备的事件——来得太快,任何开关都来不及响应。
其三,保护逻辑的「大负荷」定义停留在 50 兆瓦时代。 这套逻辑看不见自己所处的更大电网,于是上游一出问题,它就做出最糟糕的选择:脱网。2024 年弗吉尼亚事件中,绝大部分损失负荷可追溯到「计数电压跌落、第三次即断开」的保护方案——完全按设计执行,只是执行在了最坏的时刻。
这不是粗糙工程,而是精细工程被负荷增长甩在了身后。
修复思路由三个动作组成,且必须同步实施。
纸面上,这是三项直白的升级;实践中,它会重写下游每一行清单。
当数千块 GPU 同时启动,系统吸收摆动,交给电网一条平坦的负荷曲线;扰动来袭时,其后的设备毫无察觉。一个「难缠的邻居」变成可预测的邻居,进而变成有用的邻居。
互联流程同样改变。公用事业公司只需认证一个中压箱体,而不必厘清其后的每一台变压器、UPS、冷水机组、水泵和开关柜组合。工程师更换芯片代际时,无需重新做互联研究,许可周期可缩短数月。
园区围墙之内,UPS 机房腾出来变成算力或制冷空间,单位建设资金的密度随之上升。经济性也随之反转:运行在中压、置于室外、自带储能的设备,可望获得税收抵免,并通过削峰、需求响应等电网项目获取收益。备用电源不再是保险费,而开始自己养活自己。
2026 年初,相关团队已对全尺寸方案展开测试。这一方向的意义,远超单座数据中心的降本增效。
从更宏观的视角看,AI 基础设施的竞争正在从「谁的芯片更强」延伸到「谁的电力系统更聪明」。国际能源署(IEA)在 Energy and AI 报告中指出,数据中心的电力需求增长正在重塑各国电网规划逻辑。与此同时,NERC 等可靠性组织已开始将「大型负荷损失」列为专项研究议题。
国内方面,DeepSeek、通义千问、豆包、Kimi、智谱 GLM 等大模型厂商的推理与训练集群,普遍部署在电网侧统一规划的园区内,由电网公司主导接入方案与调峰安排。这种「负荷跟随电网规划」的模式,在架构层面天然规避了美式数据中心「各自为政、同步脱网」的集体风险,但也对跨省绿电调度与储能配置提出了更高要求。
归根结底,AI 的电力问题不是「多发几度电」的问题,而是「电以什么架构流动」的问题。阿什本的两起事件已经证明:当负荷的行为模式发生质变,任何只盯着发电侧的讨论,都只是治标。
因为 AI 训练负荷具有毫秒级、大幅度的功率摆动特性,且各数据中心采用相似的保护逻辑。当上游电压出现跌落,这些设施会几乎同时触发脱网保护,形成吉瓦级的同步负荷损失,远超电网设计预期。
传统 UPS 变换器损耗较高,运营商为省电常开启 eco-mode,让市电通过静态开关直接供给机架。此时 UPS 实际上不参与调节,算力侧的波动原样传给电网,电网侧的暂态扰动也直接冲击设备,双向都失去缓冲。
中压运行可减少转换层级与损耗,室外模块化部署则释放机房空间用于算力与制冷。同时,此类设备更易符合税收抵免条件,并可参与削峰、需求响应等电网收益项目,把备用电源从成本项变为收益项。
国内多由电网公司主导接入与调峰规划,配合「源网荷储一体化」和储能配套来平滑算力负荷波动。这种模式在架构层面降低了多座数据中心同步脱网的集体风险,但对跨区域绿电调度与储能容量提出更高要求。
Bingdada 是一个专注 SEO、GEO(生成式引擎优化)与 AEO(答案引擎优化)的内容平台,由资深内容编辑、SEO 技术工程师与 AI 研究专家组成的团队持续运营。我们追踪搜索引擎与生成式 AI 的最新动态,为读者提供准确、实用、可落地的方法论与行业洞察。
编辑团队:内容策划 · 技术编辑 · AI 研究组
网站:bingdada.com
© 2026 Bingdada. 保留所有权利。
Поместите бренд в ленту читателя
Рекламные места внутри статей — моменты высокого внимания, идеальны для запуска продуктов и набора на мероприятия.
SEO & GEO 技术探索者,专注于搜索引擎优化和生成式引擎优化。
Anthropic、OpenAI、Google DeepMind 与 xAI 罕见地在「放缓大模型发展」上达成公开共识。但细读事故报告会发现,被包装成「力量失控」的事件,更像是一次训练流程缺陷。本文拆解安全叙事与 IPO 竞争逻辑之间的张力。
英伟达 CEO 黄仁勋在 All-In Summit 现场接到特朗普电话,双方一致反对放缓 AI 发展。这场连线背后,是硅谷「加速派」与「减速派」的路线分歧,以及七成美国民众反对本地新建数据中心的现实压力。
Google DeepMind 在欧洲启动为期三个月的机器人加速器,支持 15 家具身智能初创企业,覆盖工业、医疗、建筑与海洋等场景,释放出物理 AI 从研究走向工程化落地的明确信号。
Получайте свежие материалы по SEO и GEO.
Мы уважаем вашу конфиденциальность. Отписаться можно в любой момент.
Войдите, чтобы присоединиться к обсуждению
