 bingdada
OpenAI 在 GPT-6 中推出改进版提示缓存,默认命中率更高,30 分钟内复用共享前缀可享折扣,缓存输入令牌最高省 90%。新增监控面板和诊断工具,帮助开发者优化持久智能体的推理成本与响应速度。
当智能体需要连续数小时处理复杂任务——比如重构代码库、撰写深度研究报告或生成演示文稿——背后往往是成百上千次 API 请求的接力。这些请求通常携带大量重复的指令、工具定义和上下文,如果每次都从头计算,不仅响应慢,成本也会失控。OpenAI 在 GPT-6 系列中推出的改进版提示缓存(Prompt Caching)系统,正是为了解决这一痛点。
与早期版本相比,GPT-6 的缓存系统在默认状态下就能实现更高的命中率。符合条件的共享前缀如果在 30 分钟窗口内被重复使用,即可享受缓存折扣。据 OpenAI 官方数据,缓存输入令牌最高可节省 90% 的费用。这意味着,对于依赖长上下文连续交互的智能体应用,推理成本可以大幅下降。
GitHub Copilot 的实践提供了一个有力佐证。其首席产品官 Mario Rodriguez 透露,在与 OpenAI 合作优化缓存后,GitHub Copilot 在数十亿次请求中,需要重新处理的提示令牌占比下降了超过 50%。这不仅让推理栈更高效,也显著缩短了开发者等待首次响应的时间。
光有缓存还不够,开发者需要知道缓存到底有没有生效。为此,OpenAI 推出了 Prompt Caching Dashboard,可以直观展示应用输入中来自缓存的比例。通过输入构成图表,开发者能对比缓存与未缓存令牌的走势,及时发现命中率下滑,并评估代码变更对缓存的影响。
当遇到意外的缓存未命中时,提示缓存诊断工具可以派上用场。它会对比当前请求与近期响应,指出是模型、工具、设置还是输入发生了变化导致无法复用。诊断结果还会估算受影响的令牌数量,帮助开发者判断优化优先级。例如,一个典型的诊断输出会显示:
{
 "prompt_cache_diagnostics": {
 "type": "cache_miss",
 "reason": "tools_changed",
 "comparison_reusable_tokens": 5629,
 "cache_missed_tokens": 5629
 }
}
除了默认优化,GPT-6 还提供了一系列可选控制项,让开发者根据自身负载定制缓存行为:
configuration_update 来改变推理强度。遇到难题时调高,处理常规跟进时调低,而请求级别的推理设置保持不变,从而保留可复用的上下文。allowed_tools 限制可调用工具,或在不需要工具时设置 tool_choice 为 none,而不是直接删除定义。新增指令应通过开发者消息追加到上下文末尾,以覆盖旧指令。这些控制手段建立在引擎默认性能之上,帮助开发者针对具体工作负载精细调节。
多家企业分享了缓存优化带来的收益。Wordsmith 的首席技术官 Arian Hanifi 表示,利用诊断面板和显式断点,团队将缓存命中率提升了好几个百分点,成本降低 20%,还能在缓存意外中断时收到告警,并用 Codex 智能体诊断根因。Manus 的智能体团队负责人 Bin Fan 则提到,通过与 OpenAI 工程团队合作调整断点位置,结合显式和自动缓存,其缓存命中率在一周内从约 85% 提升到稳定超过 90%。Strawberry Browser 的 AI 工程师 Eugene Mikhantyev 也透露,迁移到显式缓存断点后,评估中的命中率从 83% 升至 91%,缓存写入量减少约三分之二,推理成本下降 36%。
海外厂商在提示缓存上的持续投入,反映了智能体规模化落地的共同挑战。国内方面,百度文心一言、阿里通义千问、深度求索 DeepSeek、字节豆包、月之暗面 Kimi 以及智谱 GLM 等产品,也在上下文缓存和推理成本优化上有所布局。例如,部分国内平台已推出上下文缓存功能,允许开发者复用长文档或系统指令的中间状态,按更低的单价计费。虽然具体实现和折扣力度各有差异,但方向一致:让长周期、多轮次的智能体应用在经济上变得可行。对于国内开发者而言,关注各平台缓存策略的更新,同样是控制推理成本的关键一环。
随着 GPT-6 将缓存能力从“默认可用”推向“可观测、可控制”,持久智能体的经济账正在被重新计算。
符合条件的共享前缀在 30 分钟窗口内被重复使用时,缓存输入令牌可享受折扣,最高节省 90% 的费用。
使用提示缓存诊断工具,对比当前请求与近期响应,可识别是模型、工具、设置还是输入变化导致无法复用。
在 GPT-6 上,通过追加 configuration_update 来改变推理强度,不会破坏缓存,请求级别的推理设置可保持不变。
是的,文心一言、通义千问、DeepSeek、豆包、Kimi、智谱 GLM 等国内平台也在推进上下文缓存和推理成本优化,具体策略和折扣各有不同。
Bingdada 是一个专注 SEO、GEO(生成式引擎优化)与 AEO(答案引擎优化)的内容平台,由资深内容编辑、SEO 技术工程师与 AI 研究专家组成的团队持续运营。我们追踪搜索引擎与生成式 AI 的最新动态,为读者提供准确、实用、可落地的方法论与行业洞察。
编辑团队:内容策划 · 技术编辑 · AI 研究组
网站:bingdada.com
© 2026 Bingdada. 保留所有权利。
Put your brand in the reader feed
In-article ad slots: high-attention moments perfect for product launches and event recruitment.
SEO & GEO 技术探索者,专注于搜索引擎优化和生成式引擎优化。
Harvey 借助 GPT-6 Astra 把法院信息、律所文档与判例研究等上下文引入起草流程,输出更结构化、更贴近案件的法律文书,让律师把时间留给策略判断。
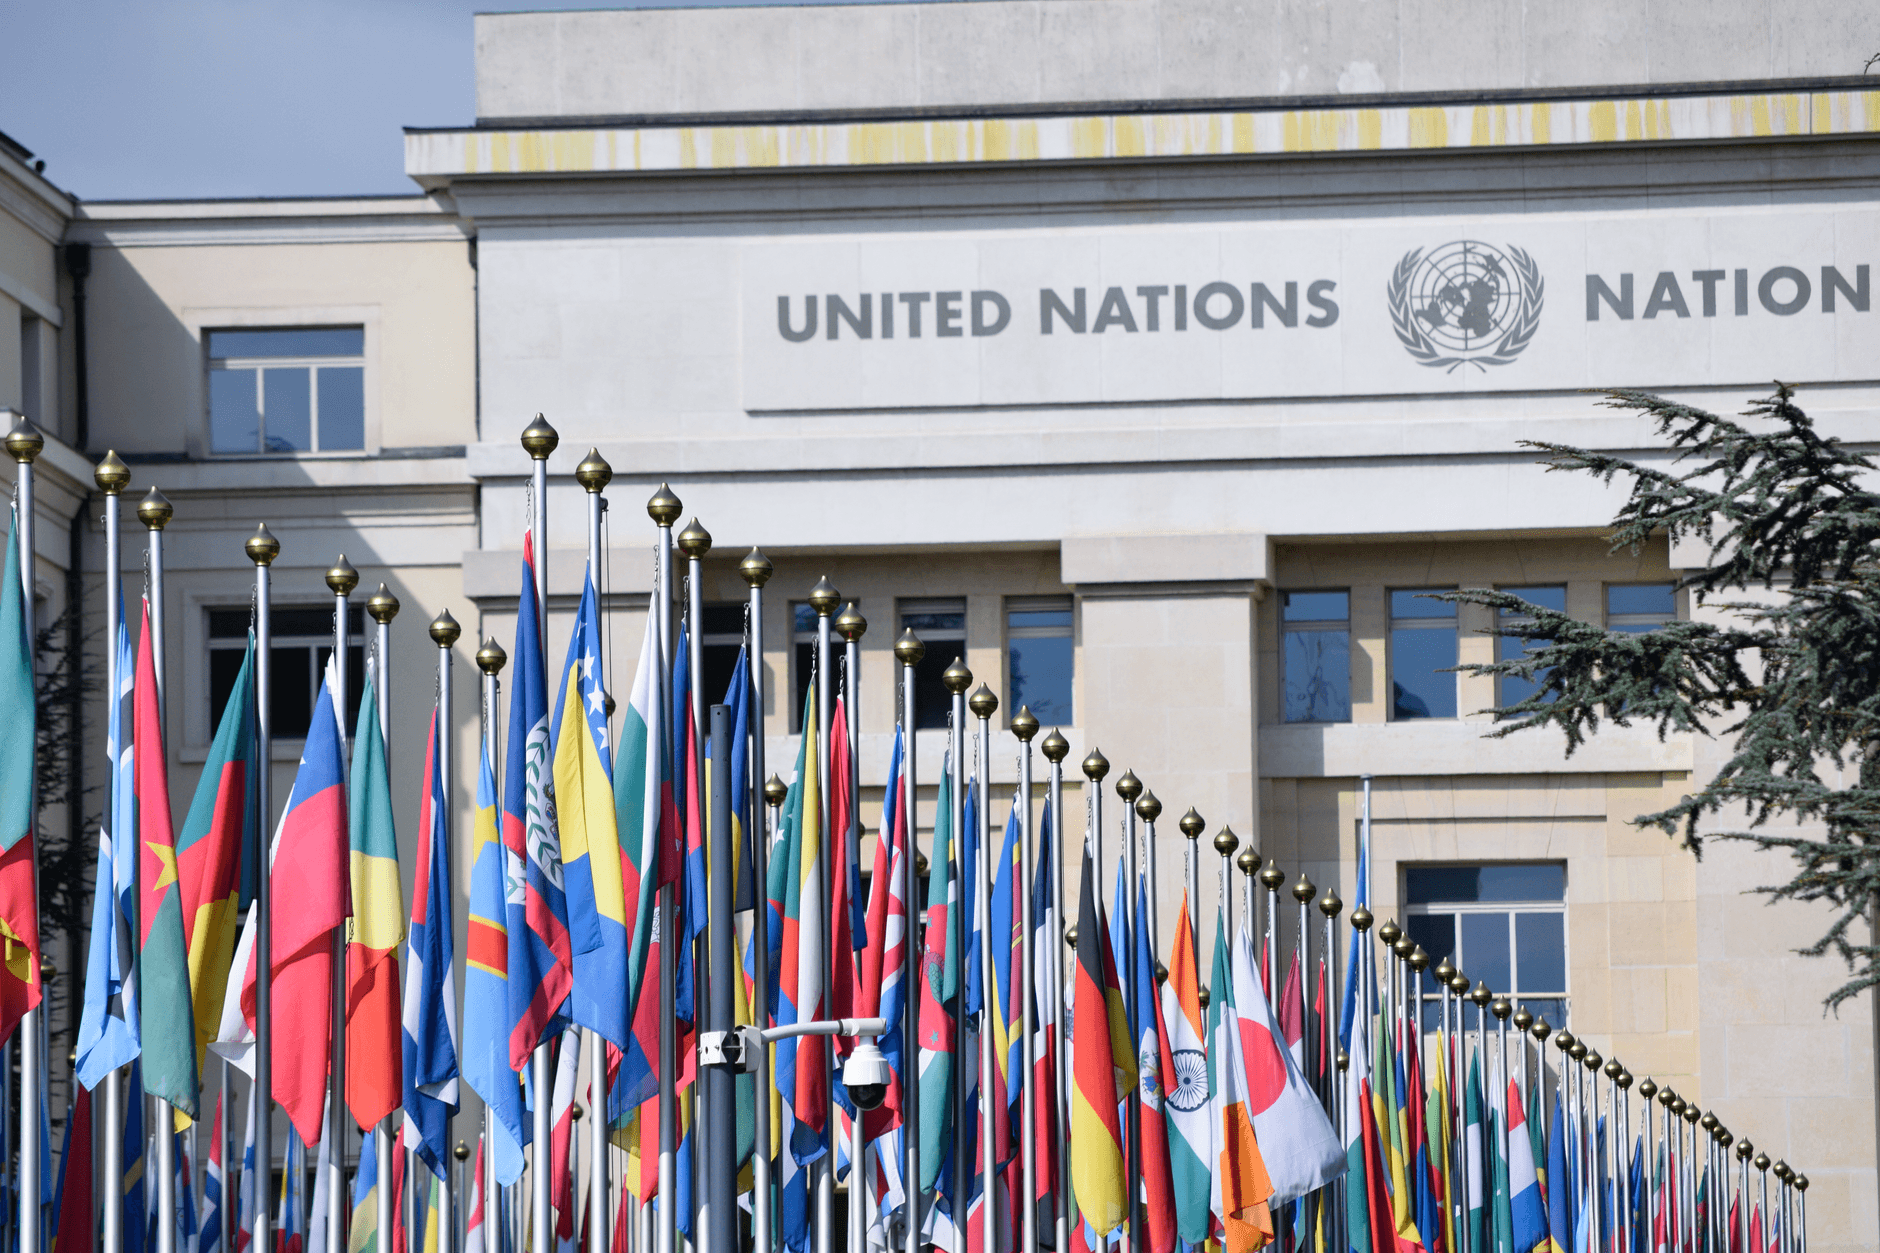
OpenAI首席执行官萨姆·奥特曼在联合国安理会就AI安全发言,提出失控与权力集中两条灾难路径,主张以人为本、广泛分享收益与国际合作,并折射出全球AI治理从能力竞赛转向治理竞赛的趋势。
车队管理软件公司 Proaction 借助 Codex 让非技术创始人独立完成定制演示,每月省下数十小时工程工时,销售转化提升约六成,并基于语音模型构建可执行维修调度等任务的智能体。
Get the latest SEO & GEO insights.
We respect your privacy. You can unsubscribe at any time.
