
AI人工智能 bingdada
AI智能体读懂湿实验数据的能力,该如何衡量?
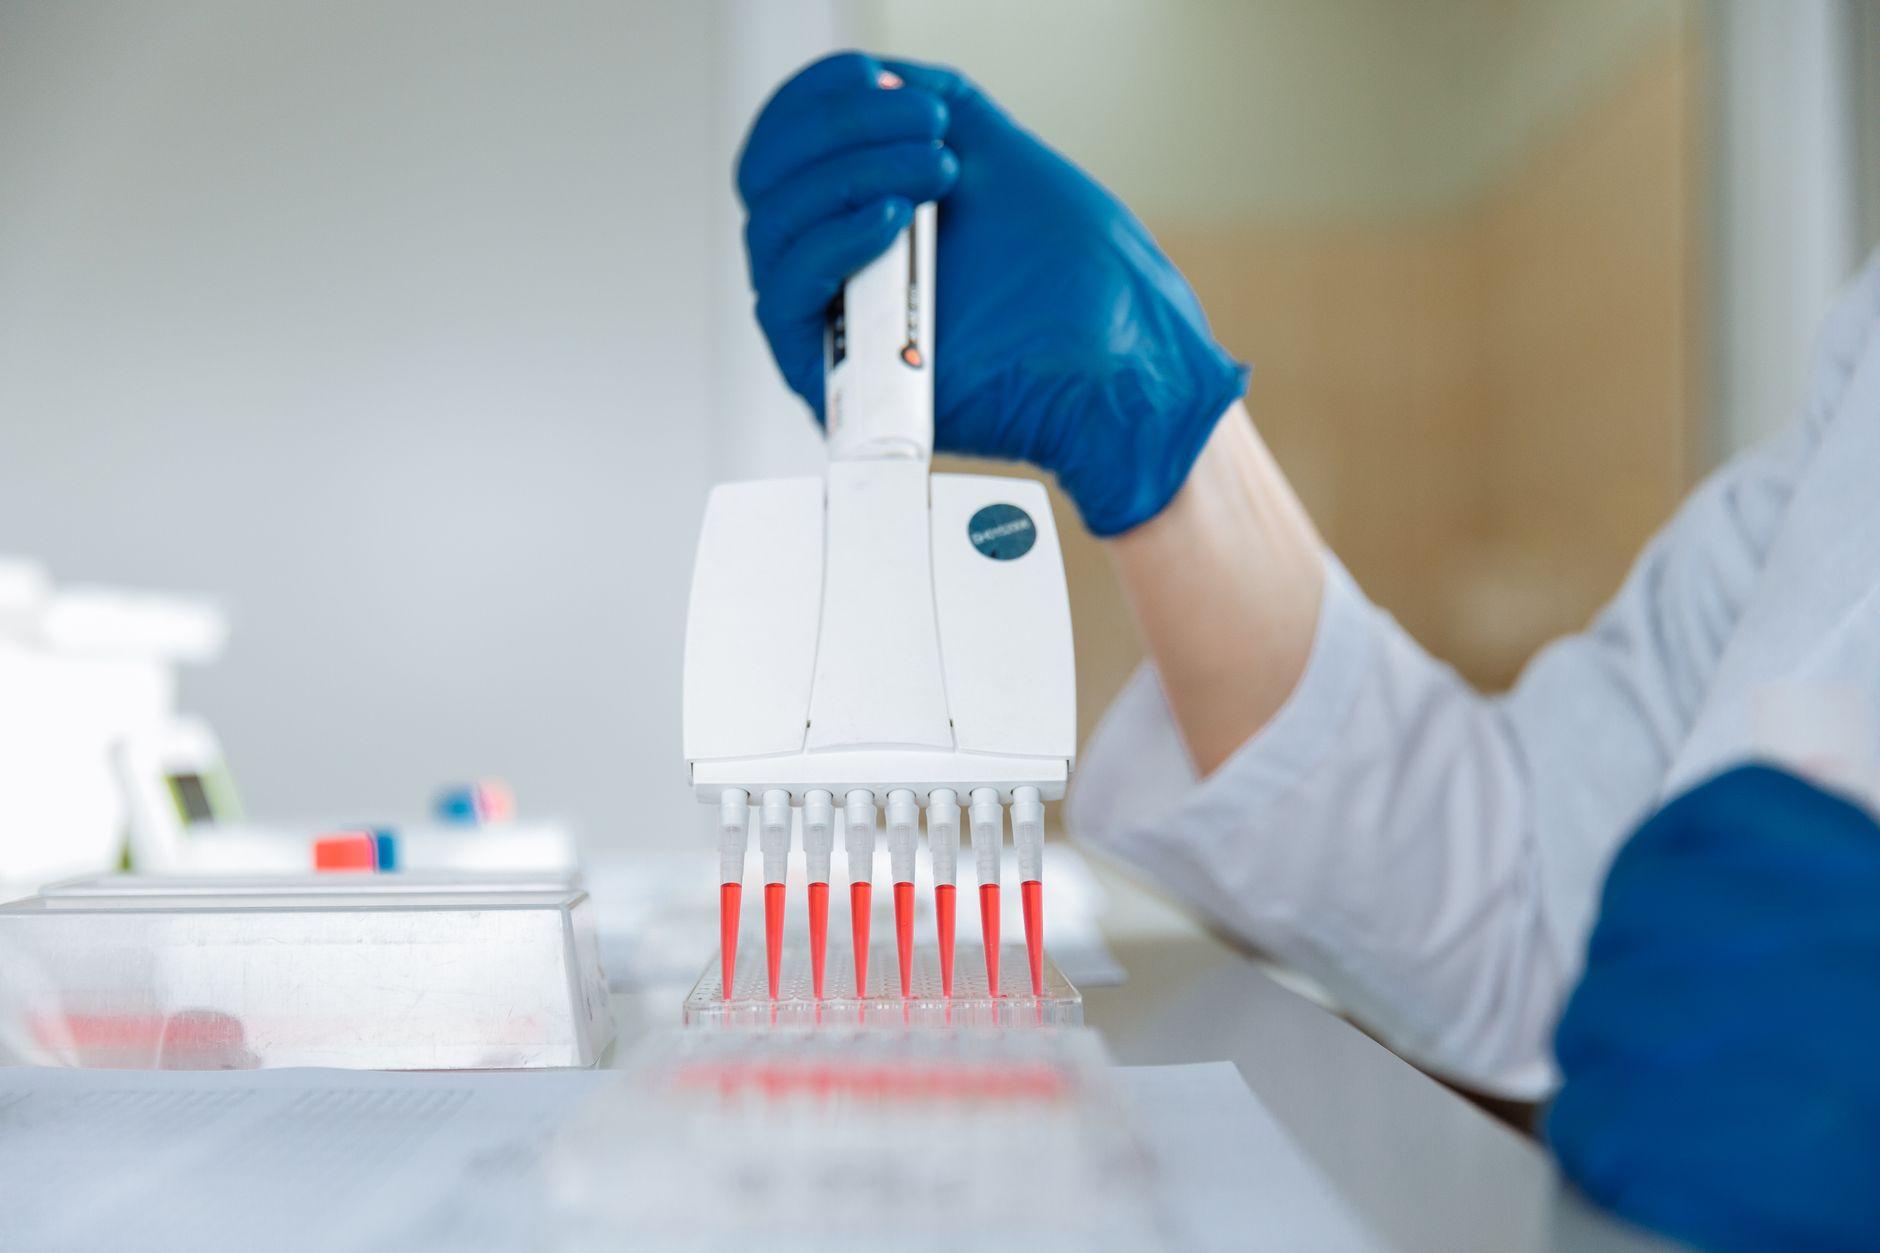
OpenAI 与 Ligo 推出 BioBasicsBench,用 100 项湿实验任务衡量 AI 智能体解读原始实验数据的能力。本文拆解其设计逻辑、GPT‑6 Astra 的成绩含义,并对照国内科研智能体的落地路径。
bingdada2026-11-081约 6 分钟阅读
浏览所有关于 SEO、GEO 和搜索优化的技术文章
OpenAI 与 Ligo 推出 BioBasicsBench,用 100 项湿实验任务衡量 AI 智能体解读原始实验数据的能力。本文拆解其设计逻辑、GPT‑6 Astra 的成绩含义,并对照国内科研智能体的落地路径。
bingdada