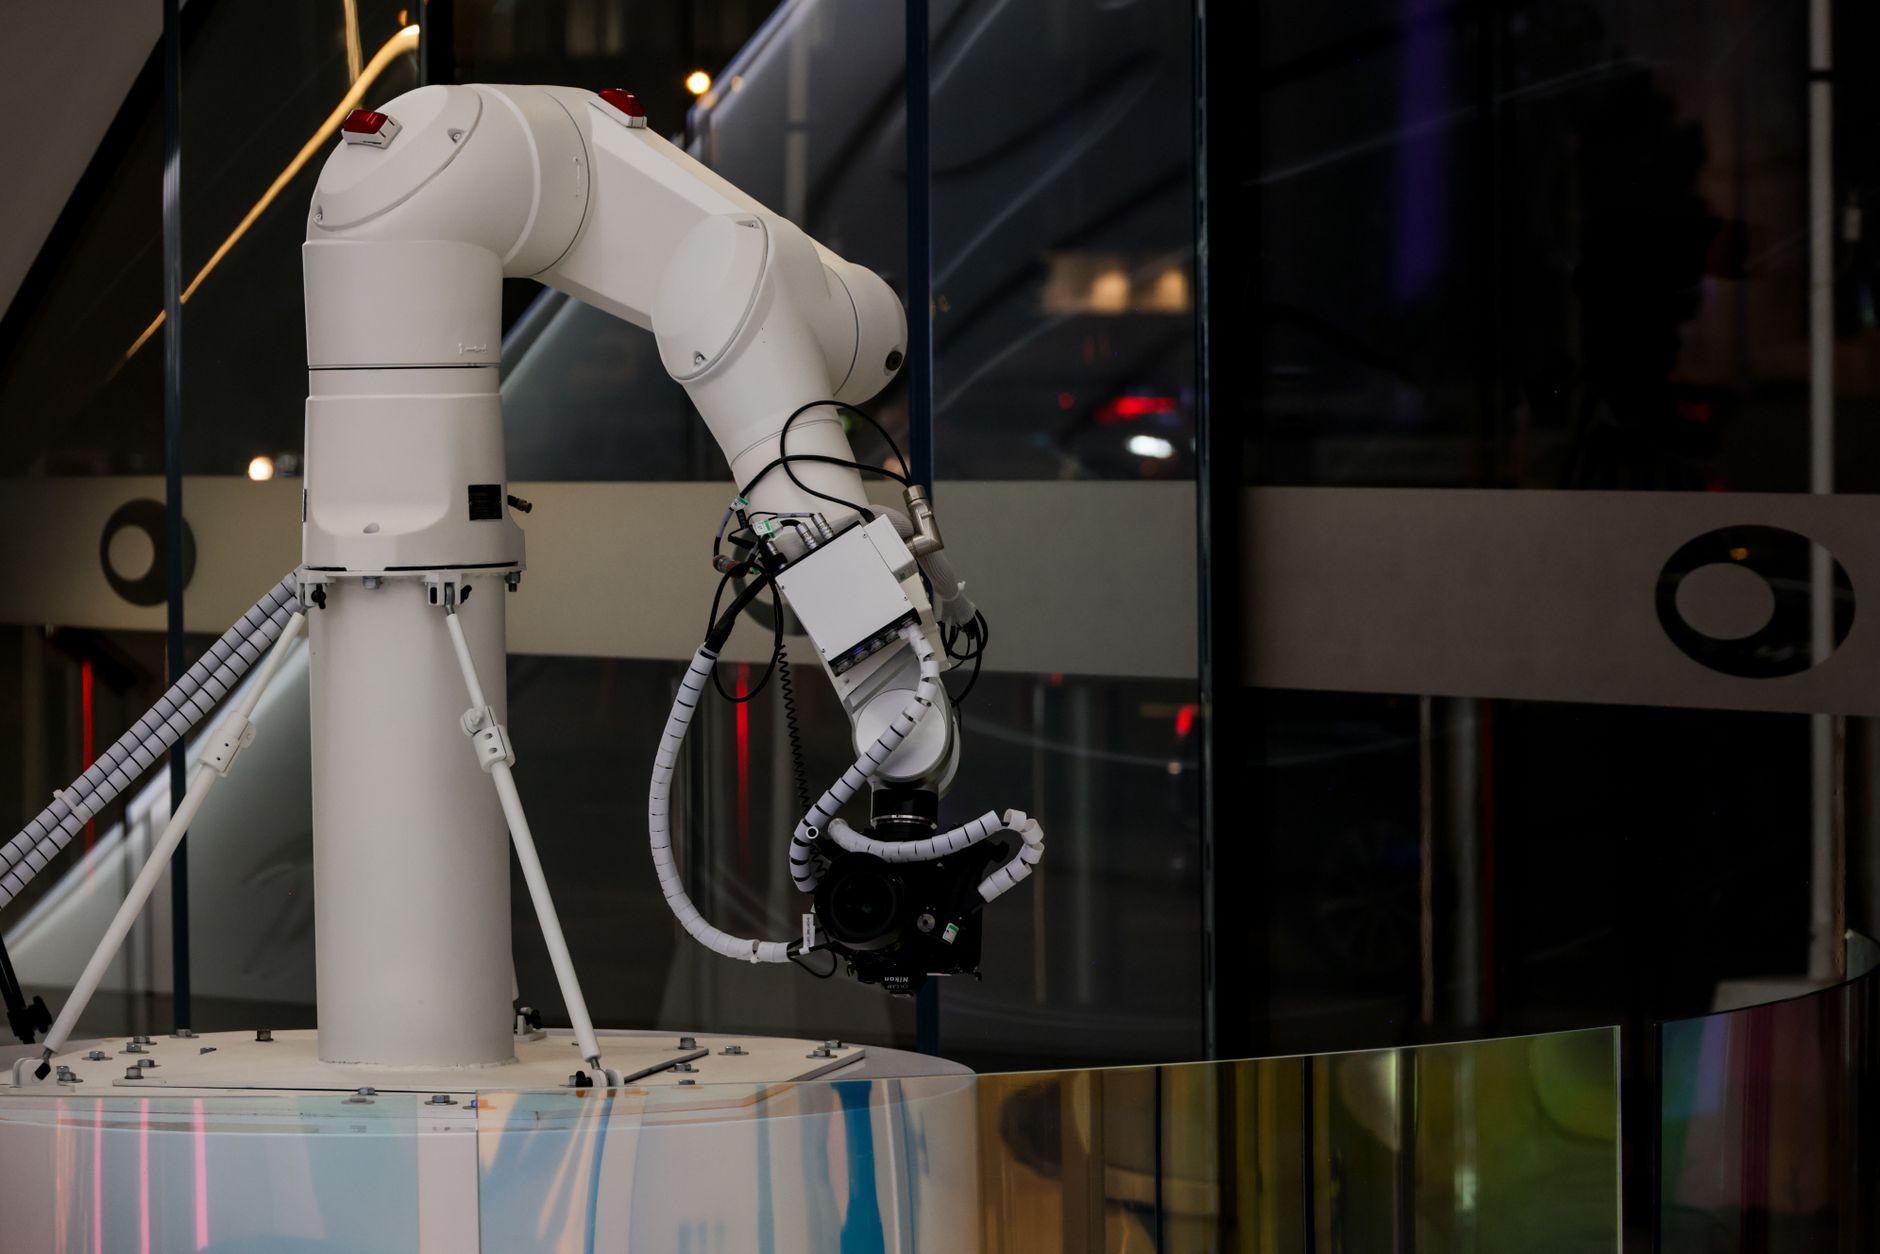
 bingdada
世界模型是让AI理解物理世界动态变化并预测行动后果的系统,与语言模型构成AGI的两条路径。生数科技发布的Motus2将评估与反馈显式纳入统一模型,使机器人能预演行动后果并自我修正,是从L3向L4自主世界智能体迈进的关键尝试。
过去几年,人工智能的叙事主线几乎被语言模型垄断。更大的参数量、更长的上下文窗口、更强的推理能力,再加上工具调用与智能体编排,构成了通往通用人工智能的主航道。这条路线确实成果斐然——机器已经能够读写、编程、检索、规划,并接管了大量原本只存在于屏幕中的复杂工作。
然而,当任务从"在网页上填完一张表格"变成"把灯泡稳稳拧进灯座"时,问题的性质发生了根本变化。机器人不仅需要识别物体,还要判断手指该如何接触、旋转会产生什么后果、拧偏了是否该停下、下一步如何修正。这需要的不是一个能描述世界的模型,而是一套能在行动前预演后果、在行动后复盘得失的内部世界模型。
这正是AGI竞争出现分岔的节点。同样脱胎于清华实验室的智谱与生数,恰好提供了两组值得对照的中国样本:前者以语言模型与智能体为核心组织能力,后者以世界生成、实时交互与世界动作模型为线索推进。它们如同在同一座山的两面攀爬——一面从人类已编码的语言和知识出发,另一面从世界持续发生的变化与反馈出发。
"世界模型"这个术语正在被不同领域从不同入口使用,导致概念边界日益模糊。视频生成领域希望模型学会世界如何随时间展开:人物转身后是否还是同一个人,镜头移动后空间关系是否依然成立。空间智能领域希望模型生成可从不同视角检验的环境。机器人和自动驾驶则必须回答一个更苛刻的问题:如果我向左移动两厘米、夹爪收紧一点、手腕多转五度,世界接下来会变成什么样?
表面上看,这些方向产出的东西不同——像素、空间状态、动作轨迹。但底层都绕不开同一个闭环:智能体观察世界,采取行动,行动改变世界,新世界再产生新的观察。
2025年6月,李飞飞与World Labs团队在论文《A Functional Taxonomy of World Models》中,从经典POMDP框架出发,将当下被称为世界模型的系统概括为三种主要功能:输出像素观测的渲染器、输出几何或物理状态的模拟器,以及输出下一步行动的规划器。这套分类的价值在于先厘清了"大家到底在做什么"。
两个月后,朱军团队发布《General World Models from First-Principles》,从另一个方向向前推进。如果说前者问的是"今天被称作世界模型的系统分别输出了什么",后者问的则是"一个模型若要真正走向通用,这些能力应当如何在同一个循环中耦合、成长和自我修正"。
这两个问题并不冲突,反而构成了理解当前世界模型的一对坐标。李飞飞团队拆开了"渲染、模拟、规划"这些功能部件;朱军团队则把视线放在部件之间如何真正转起来:模型要理解此刻的世界,预测不同条件下的未来,采取改变世界的行动,再让真实反馈进入下一轮理解与决策。
这也是朱军团队所说的通用世界模型第一性原理:理解、想象、行动,不是并列的功能标签,而是一条不能断开的因果链。只会生成未来画面,模型仍可能只是一个"看起来很懂世界"的旁观者;只有当它的动作会改变环境,而环境又能反过来修正它下一次动作时,模型才开始成为这个世界里的参与者。
基于这一逻辑,朱军团队将通用世界模型划分为五个层级:L1是世界生成,模型学习世界如何演化;L2是与世界交互,外部输入开始持续改写后续状态;L3是在世界中行动,模型的动作进入环境并从环境变化中获得反馈;L4是能够围绕长期目标自主感知、规划、探索和学习的世界智能体;L5则进一步走向多个机器人、数字智能体、人类与工具之间的协同组织。这是一条自主性逐级解锁的路线图。
文章开头所说的"分岔",并不是大语言模型和世界模型的简单竞争,而是两种建造智能的原材料正在形成分工。
大语言模型所代表的路线,以文本、代码、符号和工具为主要材料。它关心的是机器怎样从读懂一句话,走向组织目标、调用外部能力,并完成需要推理和协作的复杂任务。
生数所押注的则是另一组原材料:时间、空间、视觉、动作和反馈。从Vidu的视频生成,到Vidu S1对实时交互的探索,再到Motubrain和Motus系列对世界行动模型的推进,这条路线表面上跨度很大,底层却在反复追问同一个问题:模型能否从"生成一个看上去成立的世界",走向"在一个会被自己改变的世界里持续行动"?
语言可以告诉机器人"把桌面收拾好",却不会自动告诉它:杯子里还有没有水,纸张是否已经被压在书下,抽屉为什么拉不动,玻璃边缘是否正在滑出手指。即便模型能给出一段非常漂亮的任务计划,真正落到物理世界里,仍要面对距离、重力、摩擦、遮挡、形变、延迟和不可逆的失误。
视频生成是学习世界在时间中的展开;实时交互是让外部输入改变下一刻会发生什么;机器人行动则把问题推到最难的一步——模型必须理解,自己的动作正在改变世界,而它必须承担这个改变的后果。
因此,智谱与生数这一对同出清华的对照组,并不处在同一个窄赛道。哲学家维特根斯坦在《逻辑哲学论》中提出的"语言的边界意味着世界的边界",在AI时代被赋予了新的含义。语言模型让机器更好地理解、表达、推理并调用人类已有的知识系统;世界模型路线则努力让机器获得对具体世界的动态理解,在行动之前预演,在行动之后校正。一个让智能拥有更丰富的语言与计划能力,一个让智能拥有更扎实的世界经验与因果感。
这是AGI的南北坡:有人沿着语言和符号向上,有人沿着时空和行动向上。峰顶未必近在眼前,但两条路都已经不能缺席。
以生数科技的布局为例,可以更具体地拆解通用世界模型为何重要。AI要真正进入真实世界,不只要生成看起来合理的内容,还要理解物理世界的状态与变化,并知道自己的动作会带来什么后果。
基于这一判断,生数科技关注的核心并不是"生成了多少虚拟世界",而是能否将理解、预测、行动与反馈形成一套可验证、可持续迭代的闭环。沿着五级路线,Vidu让模型学习世界如何演化,Vidu S1让外部输入可以持续改变后续状态,Motus与Motubrain则把问题进一步推到"模型的动作会如何改变世界"。
最新的Motus2是这条链路在灵巧操作上的一次推进:同一套共享参数模型既提出候选动作,也预演行动后果、评估哪一步更接近目标,并将反馈用于改进下一次选择;结合第一视角人类数据、机器人域适配与触觉反馈,它试图让机器人不只会模仿一个动作,也开始理解行动后果。
在2026外滩大会上,生数科技联合创始人、CEO骆怡航预告发布了面向灵巧操作的自进化通用世界模型Motus2。相比此前更多关注"如何理解环境、预测未来并生成动作",Motus2进一步将Evaluation和Feedback显式纳入统一模型。模型不仅可以决定下一步动作,还可以预测动作可能带来的结果,并判断这个结果是否更接近任务目标,再利用反馈优化后续策略。
由此,机器人开始形成一套更完整的闭环:行动、预测、评估、反馈,再行动。世界模型正在从"会行动",进一步走向"能够根据行动结果修正自己"。从五级路线来看,Motus2仍然建立在L3"在世界中行动"的能力之上,但已经开始探索自主评估、自主反馈和策略优化,可以看作生数科技向L4"自主世界智能体"迈出的一次初步尝试。
在世界模型这一方向上,海外以World Labs、Google DeepMind的Genie系列、OpenAI的Sora等为代表,多聚焦于从视频或交互数据中学习物理规律与空间一致性。而国内玩家则呈现出不同的切入角度:生数科技从视频生成出发,逐步向动作模型延伸;商汤的"日日新"体系强调多模态与空间智能的结合;智谱则在语言模型基础上探索具身智能与智能体编排。
值得注意的是,国内企业在数据获取上具有独特优势——制造业、物流、家庭服务等场景提供了丰富的真实操作数据,这为训练具备物理常识的世界模型提供了土壤。同时,国内对具身智能的政策支持力度也在加大,北京、上海、深圳等地均出台了相关产业规划,推动世界模型与机器人产业的协同发展。
当然,差距依然存在。在底层架构创新、大规模仿真环境构建、以及跨模态统一表征等基础研究层面,海外机构仍处于领先位置。国内团队更多是在应用层和特定场景中寻找突破口,这种"场景驱动"的路径能否反哺基础模型能力,仍需时间验证。
世界模型是让AI理解物理世界如何随时间变化、并预测行动后果的系统。大语言模型以文本和符号为主要材料,擅长推理和规划;世界模型则以时间、空间、视觉、动作和反馈为核心,关注的是在动态环境中持续行动的能力。两者并非替代关系,而是建造智能的不同原材料。
Motus2的核心创新在于将评估与反馈显式纳入统一模型。它不仅能提出动作,还能预演后果、判断是否接近目标,并利用反馈优化后续策略,形成"行动-预测-评估-反馈-再行动"的闭环。这使它从单纯的模仿学习走向了具备自我修正能力的行动模型。
L1是世界生成,学习世界如何演化;L2是与世界交互,外部输入改写后续状态;L3是在世界中行动,动作进入环境并获得反馈;L4是自主世界智能体,能围绕长期目标感知、规划、探索;L5是多智能体协同组织。层级越高,自主性越强。
语言模型从人类已编码的知识出发,让机器获得推理、表达和调用工具的能力;世界模型从物理世界的实时反馈出发,让机器获得因果感和行动能力。两者路径不同,但指向同一座山——具备完整认知与行动能力的通用智能。
Bingdada 是一个专注 SEO、GEO(生成式引擎优化)与 AEO(答案引擎优化)的内容平台,由资深内容编辑、SEO 技术工程师与 AI 研究专家组成的团队持续运营。我们追踪搜索引擎与生成式 AI 的最新动态,为读者提供准确、实用、可落地的方法论与行业洞察。
编辑团队:内容策划 · 技术编辑 · AI 研究组
网站:bingdada.com
© 2026 Bingdada. 保留所有权利。
SEO & GEO 技术探索者,专注于搜索引擎优化和生成式引擎优化。
中国气象局与中科曙光联合宣布,MCV天气-气候一体化模式依托曙光8000全国产超集群,全球首次实现5公里分辨率、10天预报1小时算完,超越欧洲中心IFS业务水平。本文从算力困局、技术突破、AI4S底座三个维度解析这一成果的深层意义。
当智能体从偶尔调用走向持续在线,算力消耗呈现结构性膨胀。本文从IDC增长数据出发,分析万亿参数模型对计算体系的连锁影响,以及芯片、存算、互连、系统协同面临的现实考验。
Google DeepMind 在欧洲启动为期三个月的机器人加速器,支持 15 家具身智能初创企业,覆盖工业、医疗、建筑与海洋等场景,释放出物理 AI 从研究走向工程化落地的明确信号。
获取最新的 SEO 与 GEO 技术资讯。
我们尊重您的隐私,随时可以取消订阅。
